Fine-tuning para detección de fraude: cuándo sí conviene

Imagina una fintech que acaba de lanzar pagos entre usuarios. En sus primeros ocho meses de operación acumuló 2.400 casos de fraude confirmados… suficiente para preocuparse, no para entrenar un modelo robusto desde cero. El equipo de datos tiene dos caminos: construir un clasificador nuevo con esos 2.400 casos, o tomar un modelo ya entrenado en fraude de pagos de otra industria y adaptarlo con fine-tuning a su propio patrón de transacciones. La decisión entre ambos caminos no es una preferencia técnica: es una decisión de costo y tiempo que la evidencia reciente permite tomar con datos, no con intuición.
Este artículo no habla de fine-tuning de chatbots ni de modelos conversacionales. Habla de fine-tuning aplicado a clasificadores clásicos, modelos de series de tiempo transaccionales y modelos de visión para documentos, el tipo de IA que ya opera dentro de la mayoría de sistemas de riesgo y compliance.
1. ¿Cuándo conviene el fine-tuning para detección de fraude?
La ventaja de transferir pesos depende del tamaño del dataset propio. El estudio Tab2Visual (ArXiv, 2025\) demostró que en datasets pequeños el preentrenamiento aporta ganancias promedio de 7,5% a 11% en AUC, mientras que en datasets masivos (\>100K registros) la mejora cae a apenas \~1%.
Con 2.400 casos, la fintech del ejemplo se ubica en la zona de mayor rentabilidad del fine-tuning. En contraste, un banco tradicional con cientos de miles de fraudes difícilmente justificará la complejidad computacional de transferir pesos.
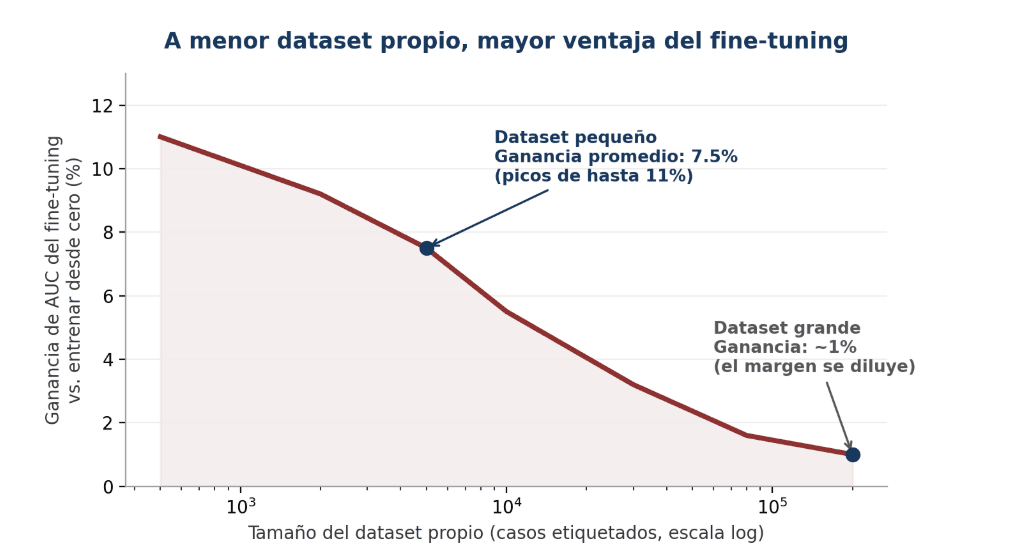
Figura 1\. Curva Tab2Visual (ArXiv, 2025): a menor dataset propio, mayor ventaja del fine-tuning (ganancia de 7,5% a 11% en AUC), frente a datasets grandes (\~1%).
¿Por qué no simplemente XGBoost o LightGBM?
En datos tabulares planos, algoritmos de boosting como XGBoost o LightGBM siguen siendo el estándar por velocidad e interpretabilidad. El fine-tuning aporta ventaja cuando los datos propios son escasos para generalizar sin sobreajuste, o cuando se integran señales multimodales: navegación web, grafos de relaciones entre cuentas y biometría de dispositivos.
Riesgos operativos: por qué el modelo exige MLOps
El beneficio del fine-tuning no es automático ni permanente. Investigaciones de transfer learning en detección de anomalías (ArXiv, 2024\) confirman que ajustar redes complejas sobre muestras reducidas acarrea dos vulnerabilidades críticas:
- Overfitting: el modelo memoriza particularidades de los fraudes históricos sin desarrollar capacidad para generalizar ataques emergentes.
- Concept drift: los patrones de fraude mutan con rapidez; un modelo estático decae en meses si las bandas delictivas varían de táctica (ScienceDirect, 2023).
Sin reentrenamiento continuo, transferir pesos traslada un riesgo financiero directo al negocio. Por ello, el fine-tuning debe concebirse como un ciclo MLOps vivo dotado de observabilidad constante y gobernanza de datos.
2. Camino práctico para decidir: caso aplicado y validación técnica
Determinar la viabilidad del fine-tuning no se define por intuición, sino aislando variables críticas y contrastando el modelo base contra un baseline en un benchmark temporal controlado.
La transferencia exige coherencia en el espacio de variables: un modelo de fraude con tarjetas transfiere eficazmente a transferencias bancarias (montos, frecuencia, geolocalización), pero falla en autenticación de identidades, donde las señales provienen de píxeles y biometría.
Variables críticas en un caso real (Fintech P2P, 2.400 fraudes):
Velocidad: transferencias salientes en ventanas de 5/15 min y ratio monto vs. saldo promedio.
Telemetría: variaciones en device fingerprint y saltos geográficos por IP en menos de 1 hora.
Topología: envíos hacia cuentas destino recién creadas (cuentas puente o mulas).
El experimento técnico: baseline vs. adaptación de capas
Sobre una partición temporal (time-based split) para evitar fuga de datos, se compara un modelo tabular entrenado desde cero (XGBoost) frente a una red neuronal preentrenada en patrones de pago.
En la práctica, la adaptación del modelo base no entrena toda la red, sino que congela las representaciones universales (backbone) y ajusta únicamente la cabeza de clasificación con una tasa de aprendizaje baja (10⁻⁴):
import torch.nn as nn

def preparar_modelo_finetuning(modelo_preentrenado, num_variables_locales):
    # 1. Congelar pesos base para preservar representaciones y evitar overfitting
    for param in modelo_preentrenado.backbone.parameters():
        param.requires_grad = False

    # 2. Reemplazar la capa de salida para calibrarla a los 2.400 fraudes propios
    embedding_dim = modelo_preentrenado.backbone.output_dim
    modelo_preentrenado.classifier = nn.Sequential(
        nn.Linear(embedding_dim, 32),
        nn.ReLU(),
        nn.Dropout(0.3),
        nn.Linear(32, 1)  # Salida sigmoide para probabilidad de fraude (0 a 1)
    )
    return modelo_preentrenado
Matriz de decisión y métricas de impacto
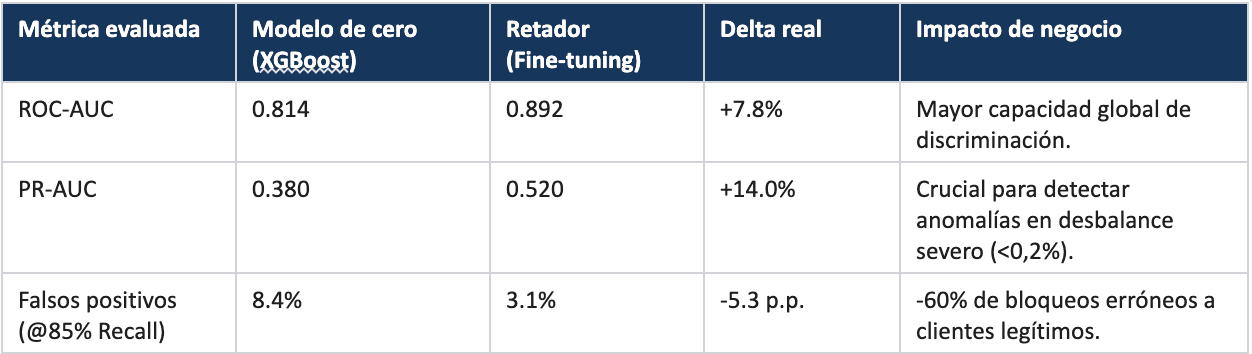
Compuertas de decisión (Decision Gates):
NO-GO (Delta PR-AUC \< \+3%): descartar fine-tuning. El margen no compensa mantener redes neuronales; conviene sostener XGBoost y optimizar variables manuales.
GO (Delta PR-AUC \> \+5% y caída de alertas): luz verde a producción. Queda demostrado matemáticamente que transferir pesos aportó generalización que los datos propios no lograban solos, justificando el despliegue de la arquitectura en AWS.
3. Arquitectura MLOps en AWS y optimización FinOps
Desplegar fine-tuning en entornos productivos regulados exige gobernanza, elasticidad y trazabilidad. En Kranio.io diseñamos arquitecturas MLOps en la nube que orquestan este ciclo de forma integral sobre AWS SageMaker:
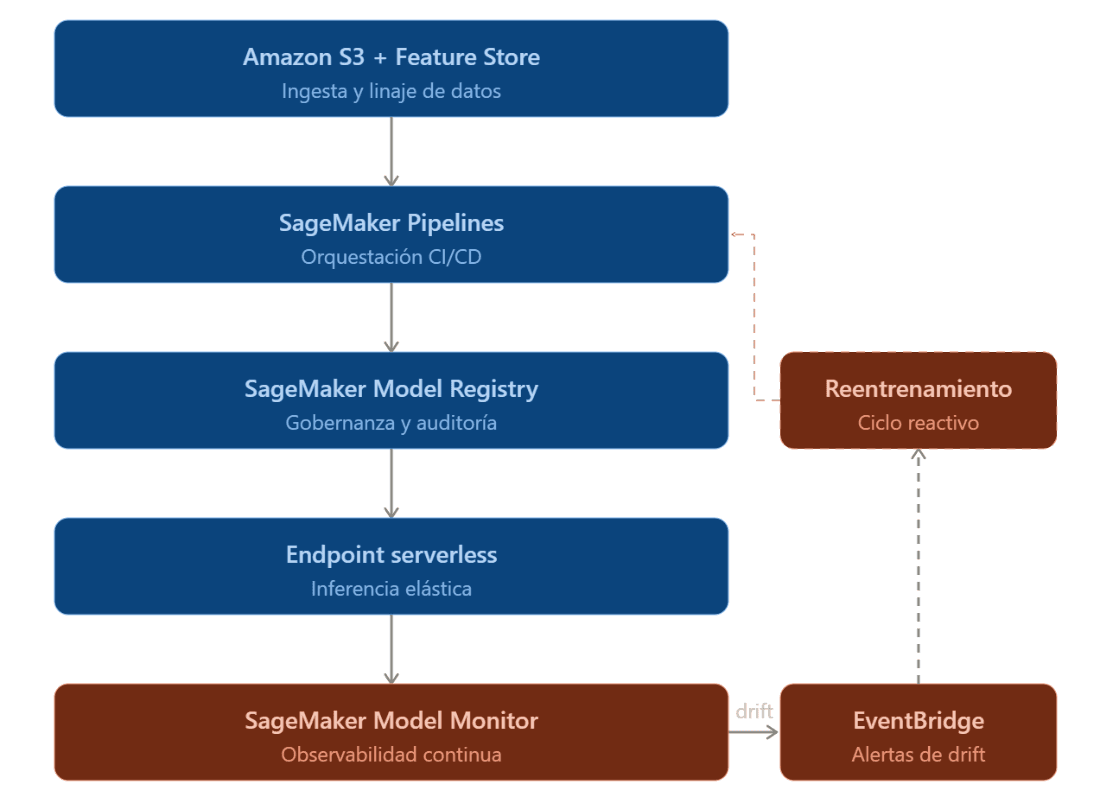
Figura 2\. Arquitectura de referencia MLOps en AWS SageMaker para fine-tuning continuo en riesgo transaccional: ingesta gobernada, pipeline CI/CD, inferencia elástica serverless y ciclo reactivo ante concept drift.
Cinco componentes sostienen este ciclo de producción:
- Ingesta y linaje: Amazon S3 y SageMaker Feature Store versionan variables, evitando el training-serving skew.
- Orquestación: SageMaker Pipelines automatiza preparación, ajuste y evaluación en flujos versionados y reproducibles.
- Gobernanza: SageMaker Model Registry audita linaje y exige aprobación humana antes de promover a producción.
- Inferencia: Endpoints Serverless con Provisioned Concurrency absorben picos con baja latencia y sin costos ociosos.
- Observabilidad activa: SageMaker Model Monitor detecta drift y dispara reentrenamientos vía Amazon EventBridge.
FinOps: el costo real de la inferencia frente al entrenamiento
En riesgo transaccional, el costo crítico no es entrenar sino la disponibilidad: reentrenar 20 horas en GPU (ml.p3.2xlarge) cuesta \~US$76 puntuales; sostener un endpoint dedicado 24/7 demanda \~US$165,60/mes fijos.
En Serverless (2 GB, 100 ms), evaluar 10 millones de transacciones mensuales cuesta \~US$40,16 (\~US$0,000004 por evaluación). El breakeven frente a instancias dedicadas ocurre recién en \~41 millones de transacciones al mes. Mediante prácticas de optimización FinOps, las instituciones pueden auditar el consumo efectivo de cómputo y dimensionar la infraestructura según la estacionalidad del negocio.
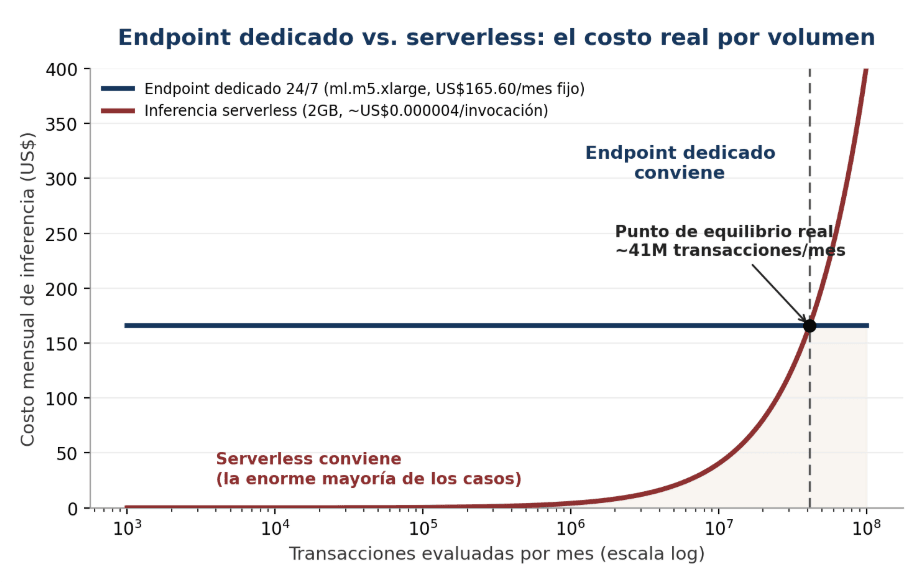
Figura 3\. Curva FinOps en AWS SageMaker: costo de inferencia dedicado vs. serverless. El punto de equilibrio (breakeven) ocurre en \~41 millones de transacciones al mes.
Mitigando el cold start: arquitectura Dual-Tier Scoring
Para superar el arranque en frío (cold start) en Serverless sin absorber costos fijos dedicados, el patrón recomendado es Dual-Tier Scoring:
- Capa 1 — Validación en línea (\<50 ms): un clasificador liviano o reglas evalúa la transacción en el flujo crítico, aprobando o bloqueando casos evidentes.
- Capa 2 — Scoring profundo asíncrono: transacciones dudosas pasan por colas de eventos al modelo con fine-tuning, evaluando patrones complejos sin demorar la respuesta.
4. Aplicación en empresas: impacto real en banca, fintech y e-commerce
Comprender la viabilidad algorítmica y la arquitectura en la nube permite dimensionar cómo estas soluciones operan en el mundo real. La efectividad del fine-tuning y MLOps cuenta con implementaciones a gran escala en producción auditadas por la industria financiera global, aportando beneficios medibles en eficiencia operativa, ahorro de costos y escalabilidad:
HSBC y Google Cloud: Dynamic Risk Assessment (DRA) a escala global
El desafío: los sistemas tradicionales contra el lavado de dinero (AML) y fraude bancario dependían de motores de reglas fijas. Este esquema generaba millones de alertas mensuales con una tasa de falsos positivos superior al 95%, obligando a cientos de analistas a demorar varias semanas investigando transacciones legítimas.
La solución tecnológica: en alianza con Google Cloud, HSBC implementó Dynamic Risk Assessment (DRA), adaptando la base de AML AI mediante fine-tuning sobre los registros históricos y de cumplimiento del propio banco. En vez de evaluar reglas aisladas, la red neuronal analiza grafos de relaciones entre cuentas, secuencias temporales de transferencias y anomalías sutiles en el comportamiento de clientes.
Impacto medido en producción:
- Monitoreo activo de más de 1.000 millones de transacciones mensuales en mercados como Reino Unido, México y Singapur.
- Detección de 2x a 4x más actividad sospechosa real frente al esquema anterior de reglas fijas.
- Reducción de más del 60% en el volumen de alertas por falsos positivos, eliminando el cuello de botella operativo.
- Compresión de los tiempos de investigación de casos de semanas a apenas unos días, hito reconocido por el Celent Model Bank Award (2023) y reportes de HSBC (2025/2026).
American Express: resolviendo el 'cold start' en nuevos segmentos
El desafío: al habilitar nuevos corredores de pago transfronterizos o categorías de comercios de nicho, la escasez de transacciones fraudulentas históricas (a menudo menos de mil casos etiquetados) impedía entrenar clasificadores supervisados robustos sin memorizar ruido.
La solución tecnológica: AmEx adoptó transfer learning y fine-tuning reutilizando representaciones neuronales profundas entrenadas sobre sus gigantescos volúmenes globales consolidados. La arquitectura congela las capas base que modelan hábitos universales de consumo y reentrena únicamente las capas densas superiores con los datos específicos del nuevo segmento.
Impacto medido en producción: la institución logró un incremento de hasta 6% en precisión predictiva (accuracy) en segmentos específicos, blindando nuevas líneas de negocio desde el primer día sin esperar años para acumular historial etiquetado (Articsledge, 2026).
Plataformas de e-commerce: detección multimodal con CFD-BERT
El desafío: en comercio digital y pasarelas de pago, los fraudes modernos (como devolución de producto vacío, apropiación de cuentas o transacciones coordinadas) burlan las tablas numéricas porque los importes y horarios aparentan legitimidad; la señal delictiva se oculta en texto no estructurado y señales de comportamiento.
La solución tecnológica: iniciativas como CFD-BERT (Consumer Fraud Detection BERT) aplican fine-tuning supervisado sobre modelos Transformer de procesamiento de lenguaje natural, adaptando los pesos contextuales para correlacionar texto en reclamos a soporte, reseñas sospechosas y metadatos de navegación de los compradores.
Impacto medido en producción: este enfoque multimodal incrementó en un 30% la detección de fraude frente a filtros heurísticos tradicionales, automatizando la clasificación semántica con un rendimiento superior a la inspección manual humana (Springer Nature, 2023; Meegle).
5. Buenas prácticas: checklist para líderes técnicos y de negocio
Antes de autorizar producción, evalúe cinco preguntas clave para asegurar la viabilidad técnica y financiera:
- Datos: ¿Están los casos de fraude confirmados y versionados en un feature store auditable?
- Métricas: ¿Qué umbral de AUC y qué costo de falsos positivos delimita la salida a producción?
- FinOps: ¿El volumen proyectado justifica Serverless con concurrencia provisionada o endpoint dedicado?
- Drift: ¿Está automatizada la detección de concept drift para disparar reentrenamientos?
- Auditoría: ¿Es posible rastrear qué versión del modelo tomó cada decisión transaccional?
6. Conclusión y llamado a la acción
El fine-tuning para detección de fraude es un multiplicador de impacto cuando los datos propios son escasos o el problema es multimodal. Respaldado por una arquitectura MLOps elástica y una estrategia FinOps de dos capas, permite a las entidades financieras proteger su operación con alta precisión y costos controlados.
La implementación de arquitecturas de fine-tuning y MLOps no solo mejora la eficiencia técnica, sino que también permite a las empresas optimizar sus procesos, reducir costos y escalar soluciones de forma segura y sostenible. En Kranio contamos con consultores y arquitectos especializados en Cloud Architecture y Data & MLOps que han implementado este tipo de soluciones en proyectos empresariales de misión crítica.
Si tu empresa busca evaluar la viabilidad de fine-tuning o modernizar su infraestructura transaccional, contáctanos en **www.kranio.io**.
Referencias
- Meegle. Supervised Fine-Tuning for Fraud Detection.
- CFD-BERT: Fine-Tuning for Consumer Fraud Detection. Springer Nature, 2023\.
- Articsledge. AI Fraud Detection in Banking: 2026 Guide.
- Google Cloud / Celent. Model Bank Award: AI-Powered Anti Money Laundering Product. 2023\.
- HSBC. Harnessing AI to fight financial crime. 2025\.
- Process Excellence Network. HSBC Dynamic Risk Assessment Case Study. 2026\.
- Tab2Visual. ArXiv:2502.07181, 2025\.
- Amazon SageMaker AI pricing. aws.amazon.com/sagemaker/ai/pricing.
Entradas anteriores
Clean Code, TDD y Git: por qué valen más que aprender 5 lenguajes
Descubre por qué dominar Clean Code, TDD, Git, patrones y convenciones puede aportar más valor a tu carrera que acumular nuevos lenguajes de programación.
Cómo construir software con Spec-Driven Development y agentes inteligentes
Descubre cómo aplicar Spec-Driven Development con agentes de IA para convertir especificaciones técnicas en software alineado con la arquitectura y el negocio.