¿Data Lake o Data Warehouse? Cuál Elegir y Diferencias
Evolución de las plataformas analíticas: Flexibilidad en el Data Lake vs Estructura en el Data Warehouse
1. Introducción: El dilema del almacenamiento y procesamiento en la era de los datos masivos
A medida que las organizaciones escalan sus operaciones digitales, el volumen, la velocidad y la variedad de su información crecen de forma exponencial. La premisa clásica de que "los datos son el nuevo petróleo" hoy se enfrenta a un desafío operativo real: sin la infraestructura adecuada, los datos no refinados se convierten en un pasivo costoso en lugar de un activo estratégico.
Al diseñar o modernizar una plataforma analítica empresarial, la pregunta recurrente de los equipos de ingeniería y liderazgo tecnológico es: ¿Data Lake o Data Warehouse? Elegir entre uno u otro no es un simple debate de marcas de software o tendencias de nube. Esta decisión define la agilidad con la que tu empresa responde a las demandas del mercado, la facilidad para entrenar modelos de Inteligencia Artificial y Machine Learning, y el impacto directo en la factura mensual de servicios cloud.
Históricamente, ambos repositorios nacieron para resolver problemas complementarios pero con filosofías opuestas. Mientras que el Data Warehouse se diseñó para la precisión matemática y los reportes de negocio estructurados, el Data Lake surgió para democratizar el almacenamiento masivo y económico de datos en su estado puro.
En esta guía técnica desglosamos las diferencias fundamentales de arquitectura, analizamos sus casos de uso empresariales más representativos y exploramos cómo la evolución hacia el Data Lakehouse está redefiniendo la toma de decisiones en las organizaciones líderes.
2. ¿Qué es un Data Lake y qué es un Data Warehouse? Explicado de forma sencilla
Para entender la diferencia conceptual sin perderse en el lenguaje técnico, resulta útil recurrir a una analogía del mundo físico: la diferencia entre un gran reservorio natural de agua y una planta embotelladora con supermercado prémium.
2.1. Data Warehouse: El supermercado estructurado
Un Data Warehouse es un repositorio centralizado optimizado para el análisis rápido de datos históricos altamente estructurados. Los datos que ingresan a un almacén deben pasar previamente por procesos estrictos de limpieza, tipado y modelado dimensional (como esquemas en estrella o copo de nieve).
Es comparable a un supermercado donde cada producto está perfectamente clasificado, etiquetado con su código de barras, pesado y colocado en una estantería designada.
- Filosofía Schema-on-Write: El esquema de la tabla debe definirse antes de poder insertar un solo registro.
- Consumidores típicos: Analistas de negocio, equipos de finanzas, directores ejecutivos y tableros de Business Intelligence (BI).
- Fortaleza: Consultas SQL ultrarrápidas, agregaciones complejas y consistencia matemática absoluta (transacciones ACID tradicionales).
2.2. Data Lake: El reservorio natural
Un Data Lake es un repositorio masivo capaz de almacenar cantidades colosales de datos en su formato original o crudo (raw), sin necesidad de estructurarlos de antemano. Puede alojar simultáneamente datos estructurados (tablas relacionales), semiestructurados (archivos JSON, logs de servidores, Parquet, XML) y no estructurados (documentos PDF, audio, imágenes y video).
Es como una gran cuenca o embalse natural que recibe agua de múltiples ríos y afluentes. El agua se almacena tal como llega y solo se filtra o purifica cuando alguien la extrae para un propósito específico.
- Filosofía Schema-on-Read: Los datos se guardan sin esquema obligatorio; la estructura se aplica mediante código al momento de leerlos o consultarlos.
- Consumidores típicos: Científicos de datos, ingenieros de Machine Learning e investigadores.
- Fortaleza: Costo de almacenamiento extremadamente bajo, flexibilidad total de ingestión y capacidad para entrenar modelos predictivos avanzados sobre datos históricos completos.
3. Matriz Comparativa: Data Lake vs Data Warehouse frente a frente
A continuación, contrastamos las dimensiones técnicas y operativas clave que determinan la viabilidad de cada tecnología en un entorno corporativo:
| Dimensión Técnica | Data Warehouse | Data Lake |
|---|---|---|
| Tipo de Datos Admitidos | Exclusivamente estructurados y relacionales (tablas, columnas tipadas). | Estructurados, semiestructurados (JSON, logs) y no estructurados (imágenes, audio, texto). |
| Definición del Esquema | Schema-on-Write (esquema rígido antes de la carga). | Schema-on-Read (esquema flexible aplicado en la lectura). |
| Costos de Almacenamiento | Altos: Almacenamiento optimizado de alto rendimiento acoplado o integrado al cómputo. | Muy bajos: Almacenamiento en capas de objetos económicos en la nube (AWS S3, Azure Blob, GCS). |
| Velocidad de Consulta | Muy rápida para consultas SQL analíticas, agregaciones y filtros de negocio. | Variable: Rápida para lecturas masivas en paralelo (Spark), pero lenta para consultas ad-hoc directas sin indexar. |
| Perfil de Usuario Principal | Analistas de BI, usuarios de negocio, directores y controllers financieros. | Científicos de datos, ingenieros de ML, desarrolladores de big data. |
| Gobernanza y Control | Muy alta y centralizada: permisos por columna/fila, catálogos estrictos y auditoría nativa. | Compleja: si no se gobierna activamente, corre el riesgo de degradarse en un Data Swamp (pantano de datos). |
| Casos de Uso Primarios | Reportes financieros, KPIs operativos, tableros de control y analítica descriptiva. | Machine Learning, analítica exploratoria, analítica de streams IoT e ingesta masiva de telemetría. |
4. Casos de uso reales: ¿Cuándo implementar cada solución?
No existe una respuesta universal a la disyuntiva de elegir un Data Lake o Data Warehouse. Las organizaciones maduras determinan la herramienta ideal en función del caso de uso de negocio y los requisitos de latencia y gobernanza.
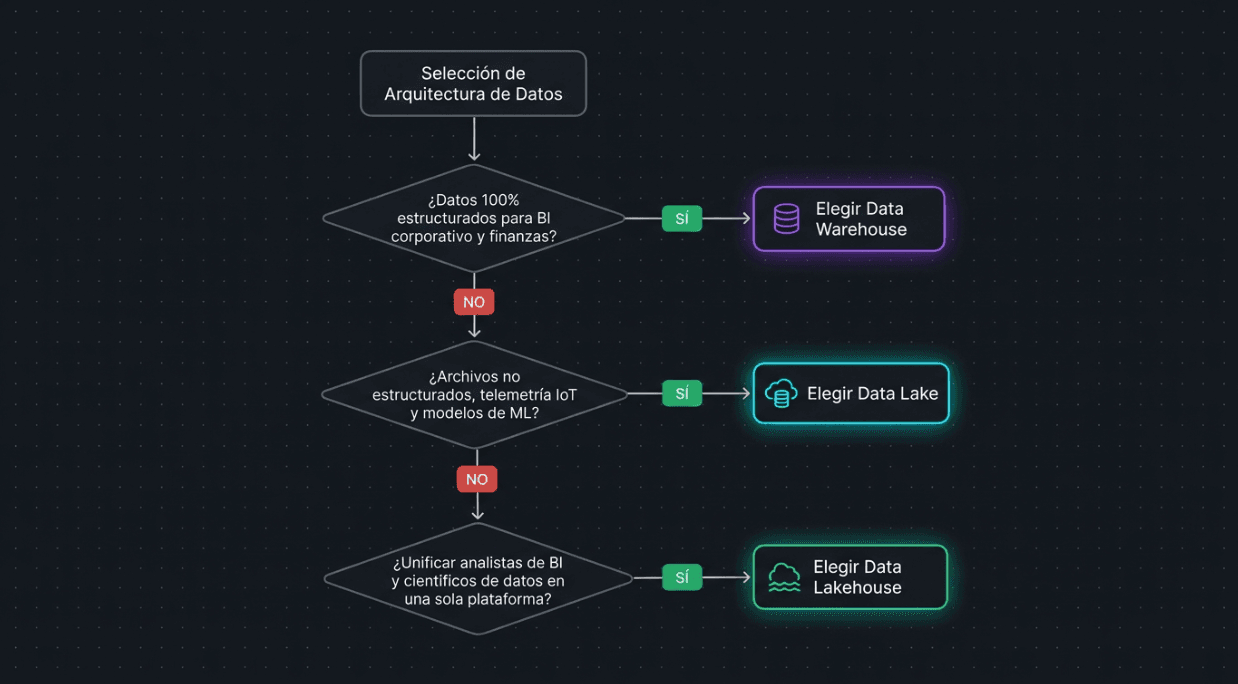
Árbol de decisión: Criterios técnicos para seleccionar entre Data Warehouse, Data Lake y Lakehouse
4.1. Escenarios donde el Data Warehouse es la elección correcta
- Cierres contables, facturación y reportes regulatorios: En sectores regulados como la banca, seguros y servicios financieros, los estados de resultados y balances generales no admiten aproximaciones. Un Data Warehouse garantiza que las cifras mostradas en los tableros ejecutivos coincidan exactamente con el libro mayor contable y los sistemas ERP principales.
- Tableros ejecutivos y BI corporativo con baja latencia: Cuando decenas o cientos de directores y gerentes de producto consultan simultáneamente tableros en Power BI, Tableau o Looker, el motor de consultas indexado y particionado de un Data Warehouse responde en milisegundos sin degradar el rendimiento.
- Métricas operativas estandarizadas de negocio: Cálculo de ingresos recurrentes (ARR/MRR), costo de adquisición de clientes (CAC) y rotación de inventarios donde toda la empresa debe compartir una "única fuente de la verdad" (Single Source of Truth).
4.2. Escenarios donde el Data Lake es la elección superior
- Modelos de Inteligencia Artificial y Machine Learning: Para entrenar algoritmos de detección de fraude, modelos de recomendación en comercio electrónico o visión computacional, los científicos de datos necesitan datos en bruto sin agregaciones previas. El Data Lake conserva los metadatos completos de red, cadenas de clics (clickstream) y marcas temporales originales.
- Ingesta masiva de IoT, telemetría y sensores: En empresas de logística, transporte o manufactura que monitorean flotas o maquinaria industrial mediante sensores que emiten millones de señales por minuto, cargar esos datos directo a un Data Warehouse resultaría inviable en costos. Un Data Lake absorbe volúmenes masivos en segundos con un costo de almacenamiento insignificante.
- Almacenamiento de archivos no estructurados para análisis futuro: Archivado de contratos digitalizados en PDF, grabaciones de llamadas de centros de atención y transcripciones de soporte técnico para posterior procesamiento de lenguaje natural (NLP) y análisis de sentimiento.
5. La convergencia moderna: ¿Qué es un Data Lakehouse?
Durante años, las empresas tuvieron que mantener dos plataformas aisladas: un Data Lake para la ciencia de datos y un Data Warehouse para el negocio, construyendo costosos pipelines de sincronización entre ambos que generaban duplicidad, inconsistencias y sobrecostos.
Para eliminar esta fricción, la industria evolucionó hacia el paradigma del Data Lakehouse, una arquitectura híbrida que implementa sobre el almacenamiento económico de un Data Lake las mejores capacidades de un Data Warehouse:
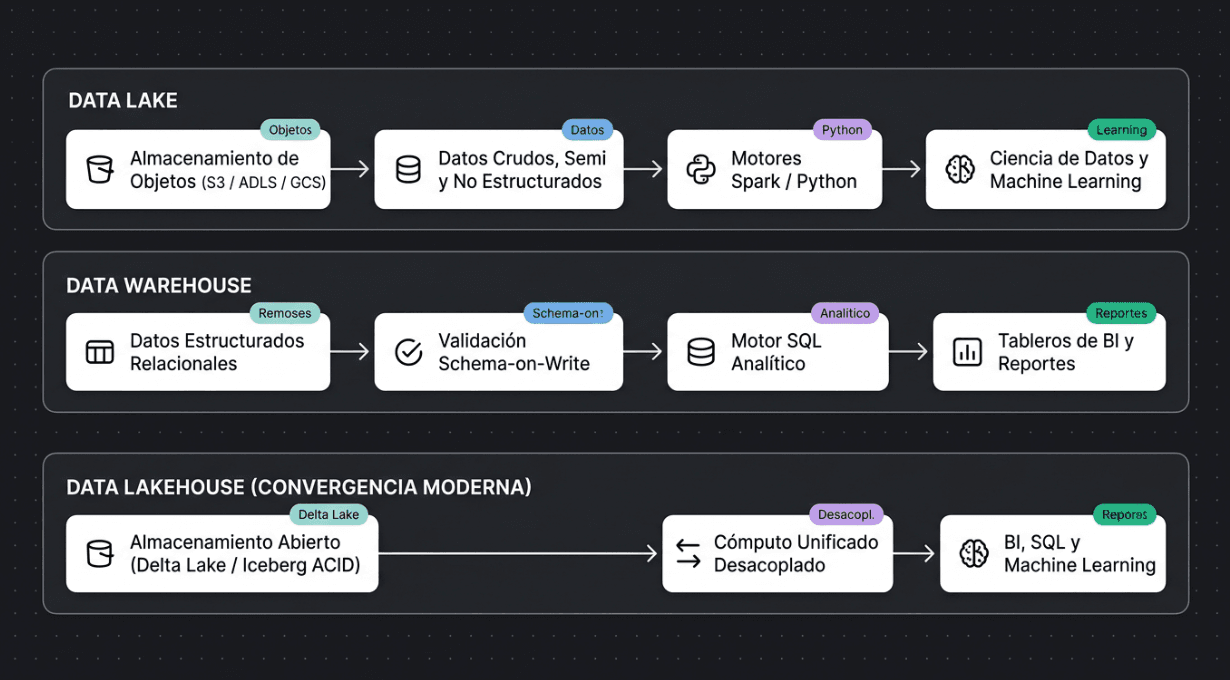
Arquitectura comparativa: Data Lake, Data Warehouse y la convergencia moderna en Data Lakehouse
Pilares del Data Lakehouse
- Formatos de tabla abiertos (Open Table Formats): Mediante tecnologías como Apache Iceberg, Delta Lake y Apache Hudi, el Lakehouse añade una capa de metadatos sobre archivos Parquet que permite transacciones ACID (atomicidad, consistencia, aislamiento y durabilidad).
- Soporte de Time Travel y Versionado: Permite consultar el estado exacto de los datos en un punto histórico anterior, facilitando auditorías forenses y reproducciones precisas de experimentos de Machine Learning.
- Desacoplamiento total entre cómputo y almacenamiento: Los datos residen en buckets seguros de almacenamiento en la nube, y múltiples motores de cómputo independientes (SQL para analistas, Python/Spark para científicos) leen directamente sobre el mismo repositorio sin duplicar datos.
6. Ecosistema de Herramientas y Gobernanza FinOps
El éxito de una arquitectura de datos moderna no depende únicamente de la tecnología elegida, sino de la disciplina financiera (FinOps) y las políticas de gobierno aplicadas desde el día uno:
6.1. Herramientas líderes del mercado
- Para Data Warehouses: Snowflake, Google BigQuery y Amazon Redshift. Destacan por su capacidad de cómputo elástico autogestionado y soporte nativo de SQL avanzado.
- Para Data Lakes: Amazon S3, Azure Data Lake Storage (ADLS Gen2) y Google Cloud Storage (GCS), complementados con motores de consulta como Apache Spark y Presto/Trino.
- Para Data Lakehouses: Databricks (pionero del concepto) y almacenes modernos con soporte de formatos abiertos como Snowflake con Iceberg Tables.
6.2. Evitando el "Data Swamp" (Pantano de Datos)
El mayor riesgo de un Data Lake es la falta de gobierno. Cuando los equipos acumulan petabytes de datos sin documentación, linaje ni catálogos, el lago se convierte en un pantano inaccesible. Para mitigarlo se requiere:
- Catálogo de datos automatizado: Uso de soluciones como Unity Catalog, AWS Glue o Apache Atlas para clasificar datasets y definir propietarios de datos.
- Políticas de ciclo de vida de almacenamiento (Lifecycle Policies): Mover automáticamente datos históricos de acceso infrecuente a capas de almacenamiento frío (Glacier / Archive) para reducir costos hasta en un 70%.
- Control de calidad en la ingesta: Validaciones automatizadas de integridad de esquemas para evitar que datos corruptos lleguen a los modelos analíticos.
7. Conclusión: El criterio para tomar tu decisión
Al responder la interrogante sobre Data Lake o Data Warehouse, la conclusión técnica de la ingeniería de datos moderna no es seleccionar uno para descartar el otro, sino evaluar la madurez de tus casos de uso:
- Si tu prioridad inmediata es el análisis de negocio, reportes financieros y dashboards estandarizados: Inicia con un Data Warehouse moderno. La velocidad de implementación y la consistencia de los datos justificarán la inversión a corto plazo.
- Si manejas grandes volúmenes de datos semiestructurados, proyectos de IA avanzada o telemetría continua: Construye un Data Lake sólido sobre almacenamiento de objetos en la nube.
- Si buscas una plataforma escalable a largo plazo que unifique a analistas y científicos de datos: Adopta una estrategia de Data Lakehouse. Esta arquitectura elimina la duplicación de datos, optimiza los costos operativos y ofrece la máxima flexibilidad tecnológica para el futuro de tu empresa.
Referencias
- Amazon Web Services. (2024). What is a Data Lake? Architecture, benefits, and data warehouse integration. AWS Cloud Data Architecture Guides. https\://aws.amazon.com/what-is/data-lake/
- Armbrust, M., Ghodsi, A., Xin, R., & Zaharia, M. (2021). Lakehouse: A new generation of open platforms that unify data warehousing and advanced analytics. Proceedings of the 11th Conference on Innovative Data Systems Research (CIDR 2021\). https\://www\.cidrdb.org/cidr2021/papers/cidr2021\_paper17.pdf
- Databricks. (2020). What is a Data Lakehouse? Architecture, governance, and unified analytics. Databricks Technical Blog. https\://www\.databricks.com/blog/what-is-data-lakehouse
- Google Cloud. (2024). What is a Data Lake? Key concepts, storage, and analytics. Google Cloud Architecture Documentation. https\://cloud.google.com/learn/what-is-a-data-lake
- Snowflake. (2024). Snowflake Data Lakes: Governed Data Lakehouse for AI and Analytics. Snowflake Product Guides. https\://www\.snowflake.com/en/product/data-engineering/data-lake/
La implementación estratégica de plataformas Data Lake, Data Warehouse y arquitecturas Lakehouse no solo moderniza el ecosistema técnico de una organización, sino que reduce sustancialmente los costos de infraestructura, acelera la toma de decisiones y democratiza el uso de la analítica avanzada. En Kranio contamos con equipos especializados de arquitectura e ingeniería de datos que han implementado soluciones analíticas de alto rendimiento en sectores empresariales de alta exigencia como banca, seguros, retail y telecomunicaciones.
👨💻 Si tu empresa busca diseñar una arquitectura de datos escalable, migrar a la nube o evaluar la viabilidad de un Data Lakehouse, puedes contactarnos en 👉 www\.kranio.io
Entradas anteriores
Archify: cómo revisar diagramas de arquitectura con IA
Descubre cómo revisar diagramas de arquitectura generados con IA, validar sus relaciones con Archify y detectar supuestos antes de utilizarlos.
Patrones y antipatrones en pruebas unitarias con JUnit y Mockito
Descubre los principales patrones y antipatrones en pruebas unitarias con JUnit y Mockito para crear tests más limpios, mantenibles y confiables.