ETL vs ELT: Diferencias, Casos de Uso y Mejores Herramientas

Infraestructura y evolución del procesamiento de datos en la nube
1. Introducción: ¿Por qué el debate entre ETL y ELT sigue más vivo que nunca?
En cualquier proyecto de datos, la meta principal es simple: tomar información de distintos lugares (bases de datos transaccionales, APIs, aplicaciones móviles o sistemas de terceros) y dejarla lista para que el negocio tome decisiones inteligentes.
Sin embargo, el camino que recorren los datos antes de llegar a un reporte o a un modelo de machine learning ha cambiado drásticamente en los últimos años. Durante décadas, el estándar indiscutible fue el modelo ETL (Extract, Transform, Load). Pero con la llegada del almacenamiento elástico y los almacenes de datos modernos en la nube (Cloud Data Warehouses), el paradigma ELT (Extract, Load, Transform) se convirtió en una alternativa potente y accesible.
Entender el debate ETL vs ELT no es una cuestión meramente semántica o de modas de software. La decisión impacta directamente cuánto dinero gastas en servidores cada mes, qué tan rápido tus analistas obtienen respuestas y qué tan fácil es cumplir con normas de seguridad o auditoría.
En esta guía explicamos qué significa cada arquitectura, en qué se diferencian, cómo se aplican en escenarios de alto rigor (con ejemplos del sector bancario y financiero) y cuáles son las mejores herramientas para implementar cada una con éxito.
2. ¿Qué es ETL y qué es ELT? Explicado de forma sencilla
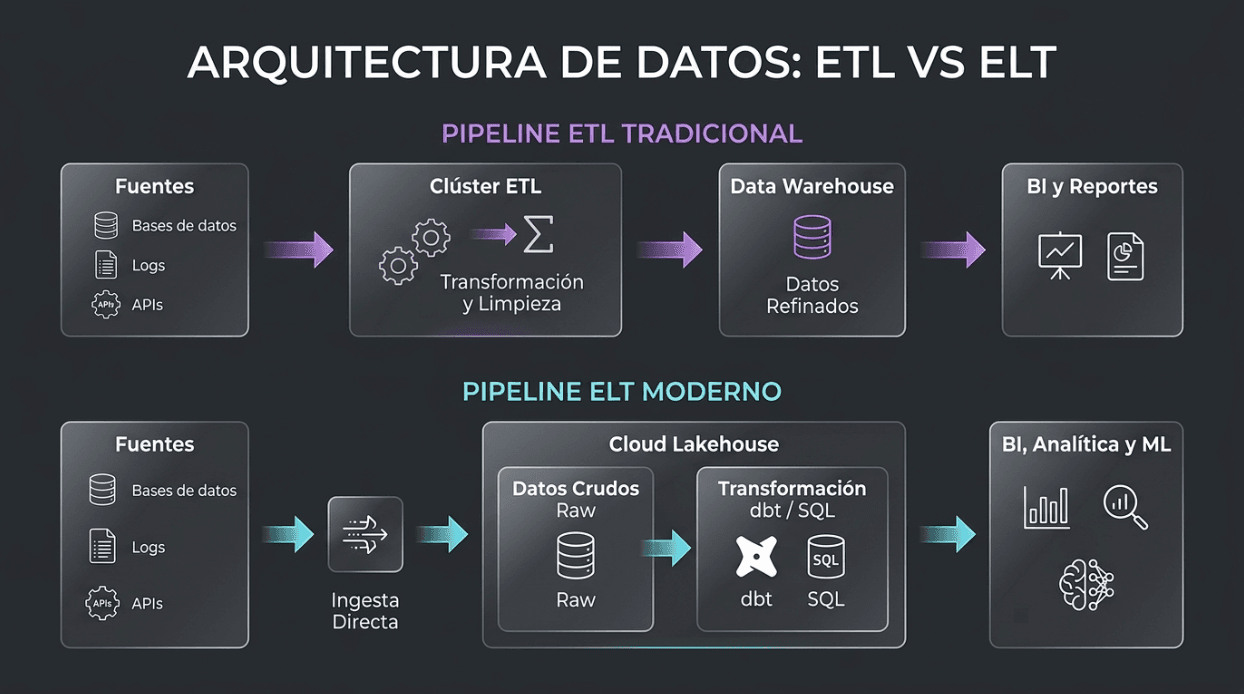
Arquitectura comparativa: Procesamiento intermedio (ETL) vs Procesamiento en Almacén (ELT)
Para entender ambos conceptos sin perderse en tecnicismos innecesarios, ayuda pensar en una analogía culinaria: la preparación de ingredientes en un restaurante.
2.1. ETL: La cocina tradicional
En ETL, los datos se extraen de las fuentes, se envían a un servidor de procesamiento independiente donde se limpian, ordenan y transforman, y solo cuando están completamente listos y pulidos, se guardan en el destino final.
Es como pelar, picar y cocinar las verduras en la cocina antes de llevar el plato a la mesa del comensal. El cliente solo ve el resultado final.
- Ventaja: Al destino final solo entran datos depurados y limpios.
- Desventaja: Si después un analista necesita un dato crudo que descartaste en la preparación previa, tienes que volver a buscarlo en la fuente original.
2.2. ELT: El buffet moderno con preparación en vivo
En ELT, primero extraes los datos y los cargas tal como vienen en un almacén central con gran capacidad de almacenamiento y cómputo. Una vez guardados los datos crudos, ejecutas las transformaciones directamente dentro del motor de destino cuando las necesitas.
Es como llevar todos los ingredientes frescos directamente a una despensa de autoservicio de alta tecnología y cocinarlos al momento según el pedido específico de cada persona.
- Ventaja: Guardas todo el histórico original sin modificarlo. Si cambian las reglas del negocio, solo cambias la consulta o modelo, sin reextraer los datos.
- Desventaja: Requiere controles estrictos de acceso para que los usuarios no consuman datos desordenados o información confidencial que aún no ha sido enmascarada.
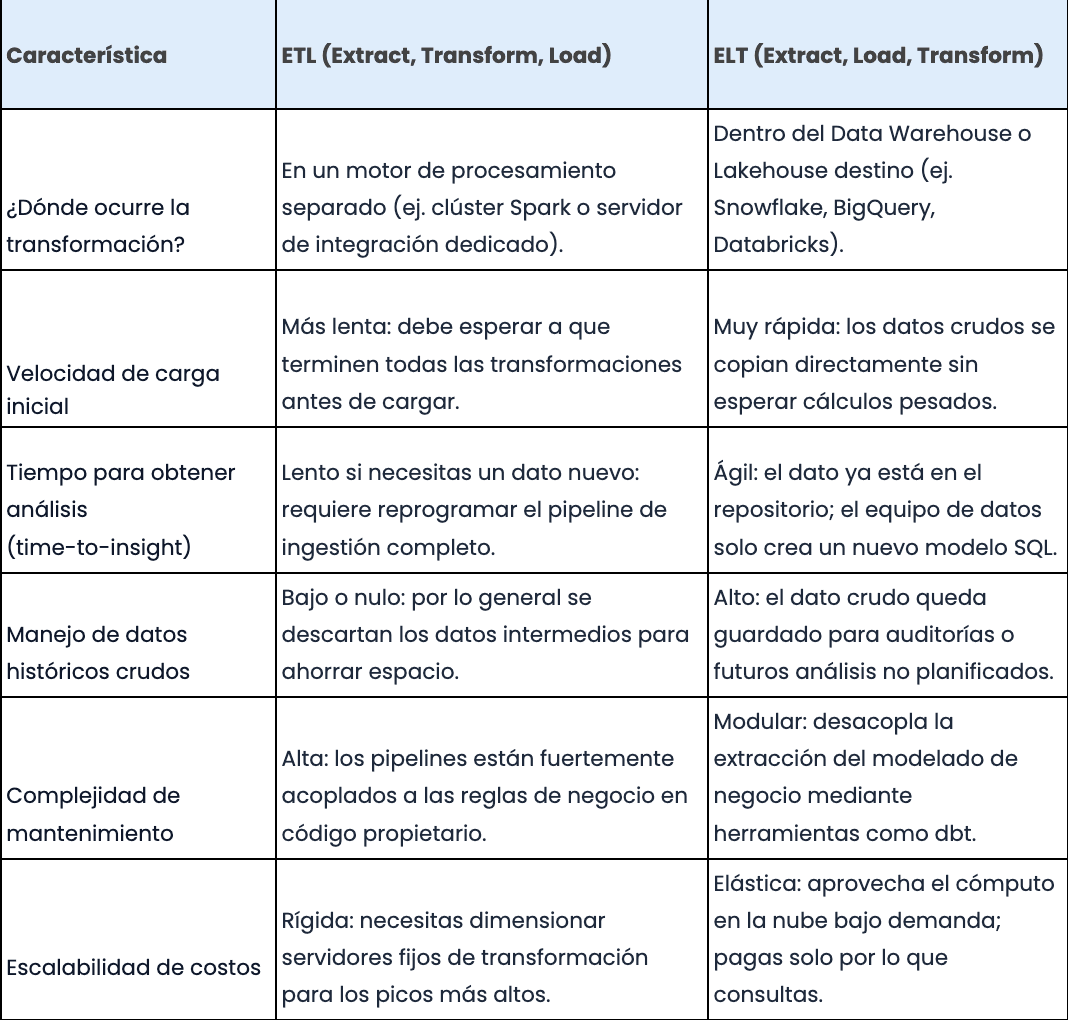
3. Diferencias clave: ETL vs ELT frente a frente
A simple vista solo parece un cambio de orden en dos letras, pero la arquitectura de fondo es totalmente diferente.
4. Casos de uso reales: ¿Cuándo elegir cada uno?
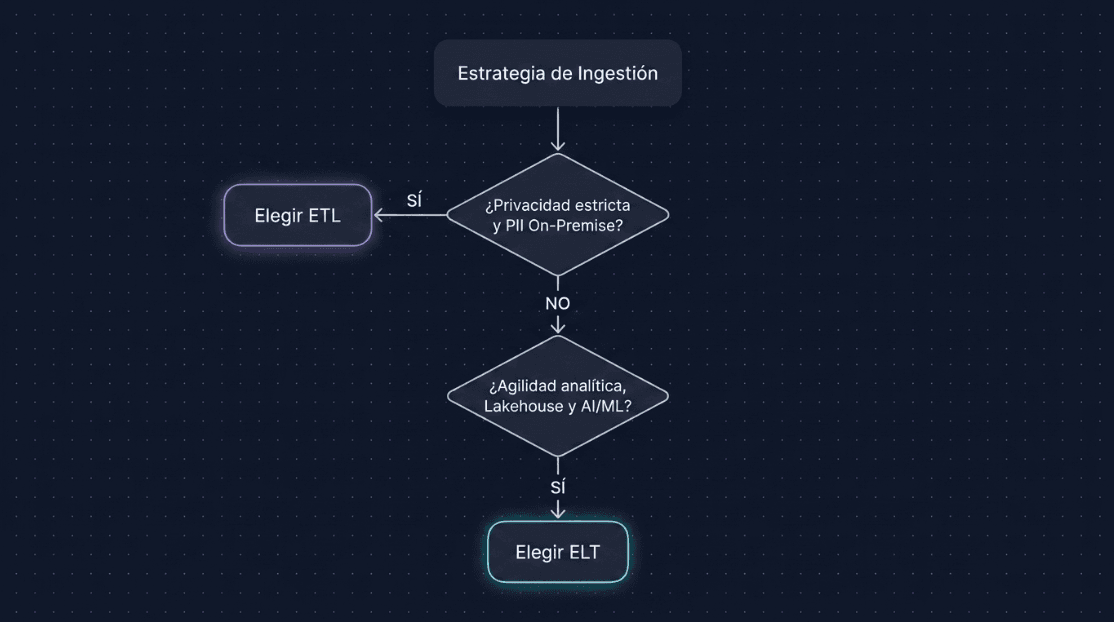
Árbol de decisión: Criterios técnicos para seleccionar entre ETL y ELT
No existe una solución única. La elección correcta depende de tus fuentes, tus restricciones regulatorias y las habilidades de tu equipo de ingeniería.
4.1. Cuándo te conviene utilizar ETL
El modelo tradicional sigue siendo el rey indiscutible en situaciones donde la seguridad estricta y los perímetros aislados no admiten flexibilidad.
- Protección de datos sensibles y privacidad (PII): En sectores como el bancario y asegurador, ciertas normas (como PCI-DSS o leyes de protección de datos personales) exigen que números de tarjeta de crédito, documentos de identidad o contraseñas jamás salgan del perímetro seguro de la empresa sin estar previamente anonimizados o tokenizados. Con ETL, los datos se enmascaran en memoria antes de transferirse a cualquier almacenamiento secundario.
- Sistemas legados con formatos complejos: Si extraes datos de un mainframe antiguo (como un AS/400 bancario) con archivos binarios o formatos propietarios (EBCDIC/COBOL copybooks), transformarlos y estructurarlos antes de cargarlos a un repositorio relacional ahorra problemas de compatibilidad.
- Consolidación de ERPs, inventarios y facturación (Tolerancia cero a inconsistencias): En sectores como retail, e-commerce, manufactura y logística, los cierres de mes y la sincronización de inventario omnicanal no perdonan discrepancias. Si se cargan datos corruptos o desfasados desde el ERP (SAP, Oracle, NetSuite), se distorsionan las existencias y los reportes fiscales. Con ETL, los datos se validan, limpian y cuadran matemáticamente antes de tocar el almacén analítico, asegurando que el negocio siempre tome decisiones sobre números auditados y exactos.
4.2. Cuándo te conviene utilizar ELT
El modelo ELT es el preferido para analítica ágil, productos digitales y ecosistemas modernos en la nube.
- Detección de fraude y scoring crediticio: Imagina un banco que analiza millones de transacciones de tarjetas de débito y crédito por segundo. Los modelos de Machine Learning necesitan no solo el monto de la compra, sino también metadatos contextuales: la IP, el dispositivo, el navegador, la latencia y la ubicación geográfica. Con ELT, toda esa información cruda se almacena inmediatamente en el Lakehouse para que los algoritmos de detección de anomalías la procesen sin filtros previos.
- Visión 360° del cliente y omnicanalidad: Un usuario consulta su saldo en la app móvil, hace una transferencia web, llama al call center y visita un cajero. Integrar todas esas fuentes dispares es mucho más sencillo si primero se depositan en bruto y luego se unifican mediante modelos SQL estructurados.
- Analítica ágil para Marketing, Producto y Ventas (Cambio continuo de métricas): En empresas con canales digitales, SaaS o e-commerce, las fórmulas para medir el valor de vida del cliente (LTV), el costo de adquisición (CAC) o la atribución publicitaria cambian constantemente. Con un esquema tradicional, cada ajuste exige abrir un ticket a ingeniería de datos y esperar semanas. Con ELT, al tener todo el historial crudo en el Lakehouse, el equipo de analítica simplemente actualiza un modelo SQL en dbt para recalcular meses de historial en minutos, sin tocar los sistemas operativos ni frenar al equipo comercial.
5. El stack moderno de datos: Las mejores herramientas
Hoy en día no necesitas construir pipelines desde cero. Existe un ecosistema robusto de herramientas líderes que resuelven cada etapa del flujo:
5.1. Para Ingestión y Replicación (E y L)
- Fivetran y Airbyte: Automatizan la extracción de cientos de conectores (SaaS, CRMs, bases de datos transaccionales) y los cargan de manera transparente en tu almacén de datos.
- Debezium \+ Apache Kafka: La opción de grado de ingeniería para capturar cambios en tiempo real (Change Data Capture \- CDC) directamente desde los logs transaccionales (Postgres, Oracle, MySQL) sin sobrecargar las bases de datos de producción.
5.2. Para Transformación y Modelado (T)
- dbt (data build tool): La herramienta que revolucionó el ecosistema ELT. Permite a cualquier persona que sepa SQL construir modelos de transformación reutilizables, documentar dependencias, gestionar linaje (data lineage) y ejecutar pruebas unitarias automatizadas con control de versiones en Git.
- Apache Spark / Databricks: La plataforma líder para transformaciones a escala masiva, procesamiento de streams en vivo y preparación de características para inteligencia artificial.
5.3. Para Orquestación y Monitoreo
- Apache Airflow y Dagster: Los estándares para programar, coordinar y alertar sobre las dependencias entre la ingestión de datos, la ejecución de modelos de dbt y el refresco de tableros de BI.
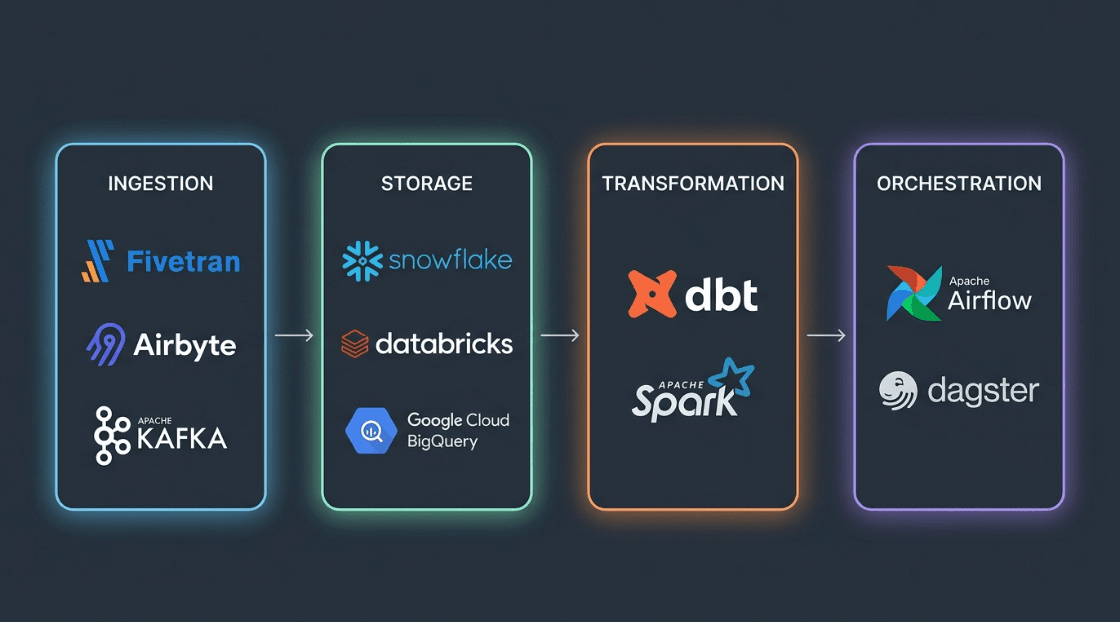
Ecosistema y herramientas líderes del Modern Data Stack
6. Impacto empresarial: ¿Cómo afecta esta decisión a tu negocio?
Elegir correctamente entre ETL y ELT no solo alegra al equipo de ingeniería; impacta directamente en el balance de la empresa:
- Aceleración del Time-to-Market: En un esquema ELT con dbt, responder a una nueva pregunta del negocio toma días o incluso horas, en lugar de las semanas que tomaba coordinar cambios en pipelines ETL heredados.
- Optimización de costos en la nube (FinOps): Los almacenes en la nube permiten suspender el cómputo cuando no se está ejecutando ninguna transformación. Ya no es necesario pagar por servidores dedicados encendidos las 24 horas solo para esperar el procesamiento de medianoche.
- Gobierno y linaje confiable: Saber con exactitud de qué tabla y columna provienen los números que ve el comité de dirección o la junta directiva evita errores costosos y agiliza las auditorías externas.
7. Conclusión: El enfoque híbrido como mejor práctica
La comparación entre ETL vs ELT no es una batalla a muerte donde un paradigma debe eliminar al otro. En arquitecturas maduras y de alta escala, la mejor práctica suele ser un modelo híbrido:
- Usa un ETL ligero al inicio: Aplica validaciones básicas de esquema y enmascara datos sensibles (PII) en el borde (edge) antes de enviar la información a la nube.
- Usa ELT para el resto del viaje: Guarda los datos en capas ordenadas (Bronze, Silver, Gold) y deja que el poder de motores modernos como Snowflake o Databricks, junto con dbt, se encargue de modelar la lógica analítica de tu negocio.
Investigaciones recientes en arquitectura de datos (Kashyap & Ramamurthy, 2025\) formalizan este enfoque como patrones híbridos ETLT (Extract-Transform-Load-Transform), donde las tareas de gobernanza y privacidad se resuelven antes de la carga, mientras que las reglas de negocio analítico se transfieren al motor elástico.
Referencias
- Amazon Web Services. (2024). Difference between ETL and ELT: Architectural patterns, performance, and use cases. AWS Architecture & Compare Guides. https://aws.amazon.com/compare/the-difference-between-etl-and-elt/
- Armbrust, M., Ghodsi, A., Xin, R., & Zaharia, M. (2021). Lakehouse: A new generation of open platforms that unify data warehousing and advanced analytics. Proceedings of the 11th Conference on Innovative Data Systems Research (CIDR 2021\). https://www.cidrdb.org/cidr2021/papers/cidr2021\_paper17.pdf
- Databricks. (2020). What is a Data Lakehouse? Architecture, governance, and unified analytics. Databricks Engineering Blog. https://www.databricks.com/blog/2020/01/30/what-is-a-data-lakehouse.html
- Rucco, C., Saad, M., & Longo, A. (2025). Formalizing ETLT and ELTL design patterns and proposing enhanced variants: A systematic framework for modern data engineering \[Preprint\]. arXiv. https://arxiv.org/abs/2511.03393
- Snowflake. (2024). ETL vs. ELT: What’s the difference and which is best? Snowflake Data Engineering Guides. https://www.snowflake.com/guides/etl-vs-elt
La implementación de arquitecturas ETL y ELT no solo mejora la eficiencia técnica del flujo de datos, sino que permite a las empresas optimizar sus procesos, reducir costos y escalar soluciones analíticas de forma segura y sostenible. En Kranio contamos con equipos especializados que han implementado este tipo de soluciones en proyectos empresariales reales dentro de sectores exigentes como banca, finanzas y retail.
👨💻 Si tu empresa busca modernizar sus pipelines de datos, optimizar costos en la nube o mejorar la gobernanza de su información, puedes contactarnos en 👉 www.kranio.io
Entradas anteriores
Fine-tuning para detección de fraude: cuándo sí conviene
Guía técnica sobre fine-tuning para detección de fraude: cuándo supera a entrenar de cero, impacto real y arquitectura MLOps en AWS.
Clean Code, TDD y Git: por qué valen más que aprender 5 lenguajes
Descubre por qué dominar Clean Code, TDD, Git, patrones y convenciones puede aportar más valor a tu carrera que acumular nuevos lenguajes de programación.