PySpark vs Spark SQL vs Scala: diferencias y rendimiento

1. Introducción: el dilema de elegir cómo trabajar con Spark
Cuando el volumen de datos de una empresa supera lo que un servidor puede procesar a tiempo, muchas recurren a Apache Spark, un motor que reparte el trabajo entre varias máquinas para procesarlo en paralelo.
Al adoptar Spark, los equipos de datos suelen hacerse la misma pregunta. ¿Cuáles son las diferencias entre PySpark, Spark SQL y Scala, y cuál conviene usar? La respuesta no es solo técnica, porque define qué perfiles necesita el equipo, cuánto toma aprenderlo y cuánto cuesta ejecutar cada proceso.
Spark fue presentado en 2010 por investigadores de la Universidad de California en Berkeley, escrito en Scala (Zaharia et al., 2010). Después sumó PySpark, para programar en Python, y Spark SQL, para trabajar con datos en forma de tabla (Armbrust et al., 2015).
En esta guía explicamos qué es cada uno, comprobamos sus diferencias con un laboratorio reproducible con datos públicos y entregamos criterios para elegir.
2. ¿Qué es Apache Spark? Explicado de forma sencilla
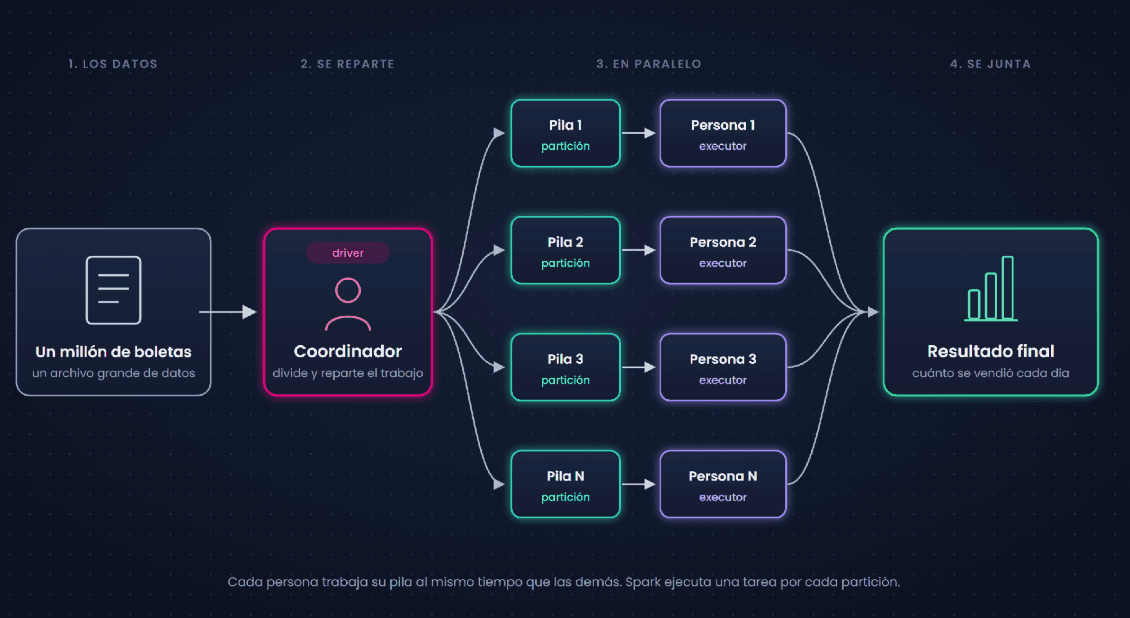
Imagina que debes revisar un millón de boletas de venta para saber cuánto se vendió cada día. Si repartes las pilas entre diez personas y al final sumas lo que contó cada una, terminas en una fracción del tiempo.
Eso es Apache Spark. Una herramienta que divide un trabajo grande con datos en partes pequeñas, las procesa al mismo tiempo y junta los resultados. La documentación oficial lo define como "un motor de análisis unificado para procesar datos a gran escala" (Apache Software Foundation, 2026a).
2.1. Cuando los datos ya no caben en un solo computador
Una hoja de Excel admite como máximo 1.048.576 filas (Microsoft, s. f.), y el archivo de taxis de nuestro laboratorio, de un solo mes, tiene 3.475.226. Superar ese límite no significa necesitar Spark.
En el mismo computador, pandas leyó ese archivo y calculó los viajes por día en 1,7 segundos. Spark se justifica cuando los datos o los tiempos de proceso superan lo que resuelve una sola máquina, y entonces reparte el trabajo entre varios computadores.
2.2. Cómo se organiza el trabajo
Alguien coordina y reparte las pilas, y cada persona cuenta la suya al mismo tiempo que las demás. En Spark, el coordinador se llama driver, las pilas son particiones y quienes cuentan son los executors (Apache Software Foundation, 2026b).
2.3. Cuándo no necesitas Spark
Con 50 boletas, repartirlas entre diez personas toma más tiempo que contarlas tú. Con Spark pasa lo mismo. Si tus datos caben cómodamente en una sola máquina, Excel, pandas o una base de datos suelen ser más simples.
3. Las diferencias entre PySpark, Spark SQL y Scala: qué es cada uno
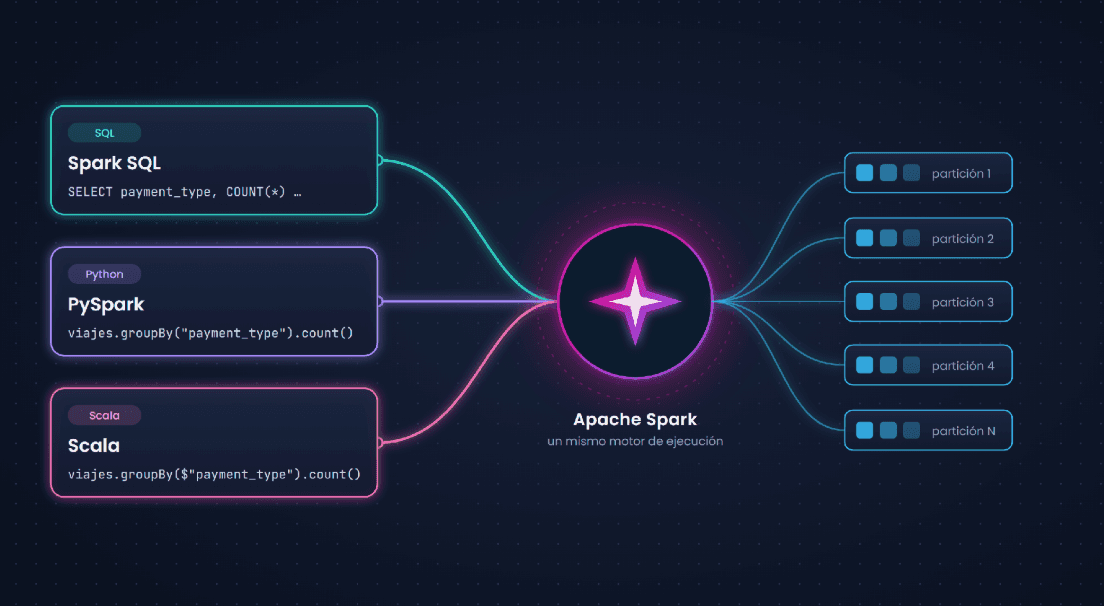
Antes de compararlos hay que aclarar que los tres nombres no son del mismo tipo. Spark SQL es la parte de Spark que procesa datos en forma de tabla, mientras que Python (con PySpark) y Scala son lenguajes desde los que le das instrucciones.
Por eso, comparar "Spark SQL contra PySpark" es comparar una consulta SQL con el mismo cálculo escrito en Python. Según la documentación, se usa "el mismo motor de ejecución, sin importar qué API o lenguaje uses para expresar el cálculo" (Apache Software Foundation, 2026c). Una API es la forma en que un programa le pide algo a otro.
3.1. Spark SQL: tú dices qué quieres y Spark decide cómo
A Spark SQL le puedes dar instrucciones con consultas SQL o con DataFrames, que son tablas repartidas en pedazos y se manejan desde Python o Scala (Apache Software Foundation, 2026c).
Dentro trabaja Catalyst, el optimizador. Tú dices qué resultado quieres y Catalyst arma un plan optimizado para calcularlo (Armbrust et al., 2015). Si vienes de bases de datos, este es tu punto de entrada natural.
3.2. PySpark: Spark desde Python
PySpark es la forma de usar Spark desde Python. Con DataFrames, el trabajo pesado no lo hace Python. Python solo le describe la tarea a Spark, y la ejecuta el mismo motor que usa SQL.
Si vienes de pandas, ten presente que Spark anota los pasos y solo los ejecuta cuando pides el resultado.
3.3. Scala: el idioma nativo de Spark
Scala es el lenguaje en que se escribió Spark desde su origen (Zaharia et al., 2010), por eso se le llama su idioma nativo.
Además tiene los Datasets, que Python no tiene. En un DataFrame, los nombres de columna son textos que Spark revisa al analizar la consulta. En un Dataset, cada fila es un objeto de una clase escrita en el código, y el compilador puede detectar ciertos errores, como un campo mal escrito, antes de que el programa empiece.
Según la documentación, los Datasets existen en Scala y Java, y "Python no tiene soporte para la API de Dataset" (Apache Software Foundation, 2026c). Si vienes de Java o del desarrollo de software, Scala te resultará natural. Si no, toma más tiempo aprenderlo.
| Spark SQL | PySpark | Scala | |
|---|---|---|---|
| Qué es | La parte de Spark que procesa tablas; se usa con consultas SQL | La forma de usar Spark desde Python | El lenguaje en que se escribió Spark |
| Perfil al que le resulta más natural | Analistas y perfiles SQL | Ingenieros y científicos de datos en Python | Ingenieros de datos y de software |
| Cuándo detecta una columna mal escrita | Al analizar la consulta, antes de procesar filas | Al analizar la consulta, antes de procesar filas | Con Dataset, ciertos errores al compilar; con DataFrame, al analizar la consulta |
| Ejemplo: viajes por tipo de pago | SELECT payment\type, COUNT(\*) FROM viajes GROUP BY payment\type | viajes.groupBy("payment\_type").count() | viajes.groupBy(\$"payment\_type").count() |
4. ¿Son tan diferentes? Lo comprobamos en un laboratorio
Para comprobarlo armamos un laboratorio con Docker, que permite repetir el mismo entorno en cualquier computador.
- Apache Spark 4.2.1 (publicado el 27 de octubre de 2026), con Scala 2.13.18 y Java 21, en modo local y con la configuración por defecto. Usamos la imagen oficial de Spark 4.2.0 de Docker Hub, actualizada con el paquete oficial 4.2.1 de Apache, y Python 3.10 con pandas 2.2.3 y pyarrow 18.1.0.
- Un solo computador con procesador AMD Ryzen 7 7730U (8 núcleos y 16 hilos) y 23 GB de RAM, con Docker limitado a 11 GB. Spark usó los 16 hilos.
- No guardamos datos en caché, así que cada medición vuelve a leer el archivo. Antes de medir cada variante hicimos una ejecución de calentamiento que no se cuenta.
- Los viajes de taxis amarillos de Nueva York de enero de 2025, publicados por la NYC Taxi & Limousine Commission (3.475.226 filas). Son datos públicos y no corresponden a ningún cliente.
- Las pruebas se ejecutaron el 29 y el 30 de octubre de 2026.
- Los scripts completos, el Dockerfile y las salidas están en este repositorio de GitHub.
4.1. La misma consulta, el mismo plan
Primero cargamos el archivo y le dimos el nombre viajes, para poder usarlo también desde SQL.
Preparación de los datos:
Python
viajes = spark.read.parquet("yellow_tripdata_2025-01.parquet")
viajes.createOrReplaceTempView("viajes")
Después escribimos la misma consulta (viajes y tarifa promedio por día) en las tres formas.
La consulta en Spark SQL:
SQL
-- Spark SQLSELECT to_date(tpep_pickup_datetime) AS dia,COUNT(*) AS total_viajes,ROUND(AVG(fare_amount), 2) AS tarifa_promedioFROM viajesWHERE trip_distance > 0GROUP BY dia
La misma consulta en PySpark:
Python
# PySpark
from pyspark.sql import functions as F
viajes.where(F.col("trip_distance") > 0) \
.groupBy(F.to_date("tpep_pickup_datetime").alias("dia")) \
.agg(F.count("*").alias("total_viajes"),
F.round(F.avg("fare_amount"), 2).alias("tarifa_promedio"))
La misma consulta en Scala:
Scala
// Scala (en spark-shell; los $"columna" vienen de spark.implicits._)
import org.apache.spark.sql.functions._
viajes.where($"trip_distance" > 0)
.groupBy(to_date($"tpep_pickup_datetime").alias("dia"))
.agg(count("*").alias("total_viajes"),
round(avg($"fare_amount"), 2).alias("tarifa_promedio"))
Luego le pedimos a Spark su plan físico, la lista de pasos que va a ejecutar, como una receta final (Apache Software Foundation, 2026e). Para compararlos reemplazamos los identificadores internos, como fare\_amount\#10, por \#id. No hace falta entender cada línea, solo ver que en este experimento la receta salió idéntica en los tres casos. La lectura del archivo va recortada, y las tres últimas líneas las imprime nuestro script.
El plan físico que mostró Spark:
Salida
AdaptiveSparkPlan isFinalPlan=false
+- HashAggregate(keys=[_groupingexpression#id], functions=[count(1), avg(fare_amount#id)], output=[dia#id, total_viajes#id, tarifa_promedio#id])
+- Exchange hashpartitioning(_groupingexpression#id, 200), ENSURE_REQUIREMENTS, [plan_id=N]
+- HashAggregate(keys=[_groupingexpression#id], functions=[partial_count(1), partial_avg(fare_amount#id)], output=[_groupingexpression#id, count#id, sum#id, count#id])
+- Project [fare_amount#id, cast(tpep_pickup_datetime#id as date) AS _groupingexpression#id]
+- Filter (isnotnull(trip_distance#id) AND (trip_distance#id > 0.0))
+- FileScan parquet [tpep_pickup_datetime#id,trip_distance#id,fare_amount#id] ... PushedFilters: [IsNotNull(trip_distance), GreaterThan(trip_distance,0.0)] ...
PLANES IDENTICOS: True
RESULTADOS IDENTICOS: True | filas: 33
PLAN SCALA IDENTICO AL DE PYTHON/SQL: true
La primera línea indica que Spark usa Adaptive Query Execution (AQE), activado por defecto desde Spark 3.2.0, que ajusta el plan con estadísticas reales mientras procesa (Apache Software Foundation, 2026h). Comparamos el plan antes de ejecutar. Al terminar, mostraba AQEShuffleRead coalesced, porque Spark juntó particiones pequeñas sobre la marcha.
El resultado tiene 33 filas y no 31 porque el archivo de enero incluye viajes con otra fecha de inicio, 21 del 31 de diciembre de 2024 y uno del 1 de febrero de 2025. No es un desfase de zona horaria, porque esa columna se guarda sin zona horaria. Los dejamos porque no cambian la comparación, pero en un proceso real conviene filtrar por el período.
4.2. Dónde Python sí cuesta: las funciones propias (UDF)
Una UDF (función definida por el usuario) es una función que escribes tú cuando Spark no trae una que haga lo que necesitas (Apache Software Foundation, 2026g). Calculamos la tarifa por milla de cuatro formas distintas y medimos cada una 10 veces, en dos corridas.
Las cuatro variantes del laboratorio:
Python
import pandas as pd
from pyspark.sql import functions as F
from pyspark.sql.functions import udf, pandas_udf
# 1. Función nativa de Spark
nativa = F.when(F.col("trip_distance") > 0, F.col("fare_amount") / F.col("trip_distance"))
# 2. La misma lógica como UDF de Python
def tarifa_por_milla(tarifa, distancia):
if tarifa is None or distancia is None or distancia <= 0:
return None
return tarifa / distancia
udf_clasica = udf(tarifa_por_milla, "double", useArrow=False) # fila por fila
udf_arrow = udf(tarifa_por_milla, "double", useArrow=True) # 3. por defecto en Spark 4.2
# 4. pandas UDF: recibe columnas completas por lotes
@pandas_udf("double")
def tarifa_por_milla_pandas(tarifa: pd.Series, distancia: pd.Series) -> pd.Series:
return (tarifa / distancia).where(distancia > 0)
# Cada variante se midió así (10 repeticiones, tomando la mediana):
viajes.select(nativa.alias("x")).agg(F.count("x"), F.sum("x")).collect()
| Variante | Mediana corrida 1 | Mediana corrida 2 | Resultado |
|---|---|---|---|
| Función nativa de Spark | 0,28 s | 0,29 s | 46.374.751,50 |
| UDF de Python clásica (fila por fila) | 1,55 s | 1,48 s | 46.374.751,50 |
| UDF de Python con Arrow | 1,23 s | 1,26 s | 46.374.751,50 |
| pandas UDF (por lotes) | 0,65 s | 0,62 s | 46.374.751,50 |
Las cuatro variantes dieron el mismo resultado, pero en estas mediciones la UDF clásica tardó unas cinco veces más que la nativa, y la pandas UDF fue la más rápida de las tres UDF.
La razón es que la UDF clásica es una caja negra para Catalyst. El optimizador no puede ver qué hace el código Python, y cada fila debe convertirse para pasar de un proceso a otro (Apache Software Foundation, 2026g). La pandas UDF usa Arrow para transferir los datos y pandas para procesarlos, "lo que permite operaciones vectorizadas" sobre columnas completas (Apache Software Foundation, 2026i).
Para verlo en el plan, filtramos por el resultado (tarifa por milla mayor a 10). Con la función nativa, el filtro se aplicó en la misma etapa que lee el archivo. Con la UDF quedó fuera de la lectura, y el paso BatchEvalPython aparece dos veces porque Spark calculó la UDF dos veces.
El filtro sobre la UDF y su plan (recortado):
Python
viajes.select(udf_clasica("fare_amount", "trip_distance").alias("x")).where(F.col("x") > 10)
Salida
*(3) Project [pythonUDF0#id AS x#id]
+- BatchEvalPython [tarifa_por_milla(fare_amount#id, trip_distance#id)#id], [pythonUDF0#id]
+- *(2) Project [trip_distance#id, fare_amount#id]
+- *(2) Filter (pythonUDF0#id > 10.0)
+- BatchEvalPython [tarifa_por_milla(fare_amount#id, trip_distance#id)#id], [pythonUDF0#id]
+- *(1) ColumnarToRow
+- FileScan parquet [trip_distance#id,fare_amount#id] ... DataFilters: [] ...
En Spark 4.2 las UDF de Python usan Arrow por defecto (Apache Software Foundation, 2026f), por eso para medir la clásica indicamos useArrow=False.
4.3. Cuándo se detecta un error de tipeo
Por último, escribimos mal a propósito el nombre de una columna (PULocationId\_typo en lugar de PULocationID, la zona donde empieza el viaje).
El error de tipeo en PySpark y Spark SQL:
Python
# PySpark
viajes.groupBy("PULocationId_typo").count().show(3)
# Spark SQL
spark.sql("SELECT PULocationId_typo, COUNT(*) FROM viajes GROUP BY PULocationId_typo").show(3)
El mismo error en Scala:
Scala
// Scala con DataFrame: el nombre de la columna es un texto
viajes.groupBy($"PULocationId_typo").count().show(3)
// Scala con Dataset: cada campo es parte de la clase Viaje
case class Viaje(PULocationID: Long, fare_amount: Double, trip_distance: Double)
val ds = viajes.select($"PULocationID".cast("long"), $"fare_amount", $"trip_distance").as[Viaje]
ds.groupByKey(v => v.PULocationId_typo).count()
Lo que respondió cada uno:
Salida
[PySpark] error al construir la consulta: UNRESOLVED_COLUMN.WITH_SUGGESTION | trabajos lanzados sobre las filas: 0
[Spark SQL] error al construir la consulta: UNRESOLVED_COLUMN.WITH_SUGGESTION | trabajos lanzados sobre las filas: 0
[Scala DataFrame] error al construir la consulta: UNRESOLVED_COLUMN.WITH_SUGGESTION | trabajos lanzados sobre las filas: 0
Scala Dataset, mensaje del compilador (no se ejecuta nada):
error: value PULocationId_typo is not a member of Viaje
Compilar es la revisión previa del programa, antes de que empiece. En este laboratorio, PySpark, Spark SQL y Scala con DataFrame detectaron el error al analizar la consulta, antes de procesar las filas (no se lanzó ningún trabajo sobre ellas), y Spark sugirió el nombre correcto. Aun así, eso ocurre con el programa ya en marcha, cuando llega a esa consulta. El Dataset de Scala lo detectó antes, al compilar.
Eso no significa que el compilador detecte todos los errores. Dentro de un Dataset, una columna escrita como texto, por ejemplo \$"PULocationId\_typo", se sigue revisando al analizar la consulta, igual que en un DataFrame.
Esa seguridad tiene un costo con funciones propias, porque Spark crea un objeto Viaje por cada fila y Catalyst no ve dentro de la función.
Con DataFrame, el filtro trip\distance \> 0 se envió a la lectura del archivo (PushedFilters: \[IsNotNull(trip\distance), GreaterThan(trip\distance,0.0)\]). Con ds.filter(v \=\> v.trip\distance \> 0\) no ocurrió (PushedFilters: \[\]), aunque en nuestro archivo la diferencia de tiempo fue pequeña, de 0,16–0,17 s a 0,18–0,21 s.
| Afirmación | Qué observamos | Resultado |
|---|---|---|
| Las tres formas generan el mismo plan | Plan físico idéntico en SQL, PySpark y Scala | Se cumplió en este experimento |
| Python es más lento | La UDF clásica tardó unas cinco veces más que la función nativa; con DataFrames, el plan fue el mismo | Depende de si usas funciones propias (UDF) en Python. Con DataFrames o SQL, en este experimento obtuvimos el mismo plan |
| Scala detecta errores antes | Con Dataset, el error apareció al compilar; con DataFrame, PySpark y SQL, al analizar la consulta, antes de procesar filas | Depende de si usas Dataset, y solo para ciertos errores. Con DataFrame, Scala lo detecta en el mismo momento que Python y SQL |
5. Cómo elegir según las diferencias entre PySpark, Spark SQL y Scala
Con estos resultados, para las consultas comunes la pregunta deja de ser cuál es más rápido y pasa a ser cuál encaja con tu equipo.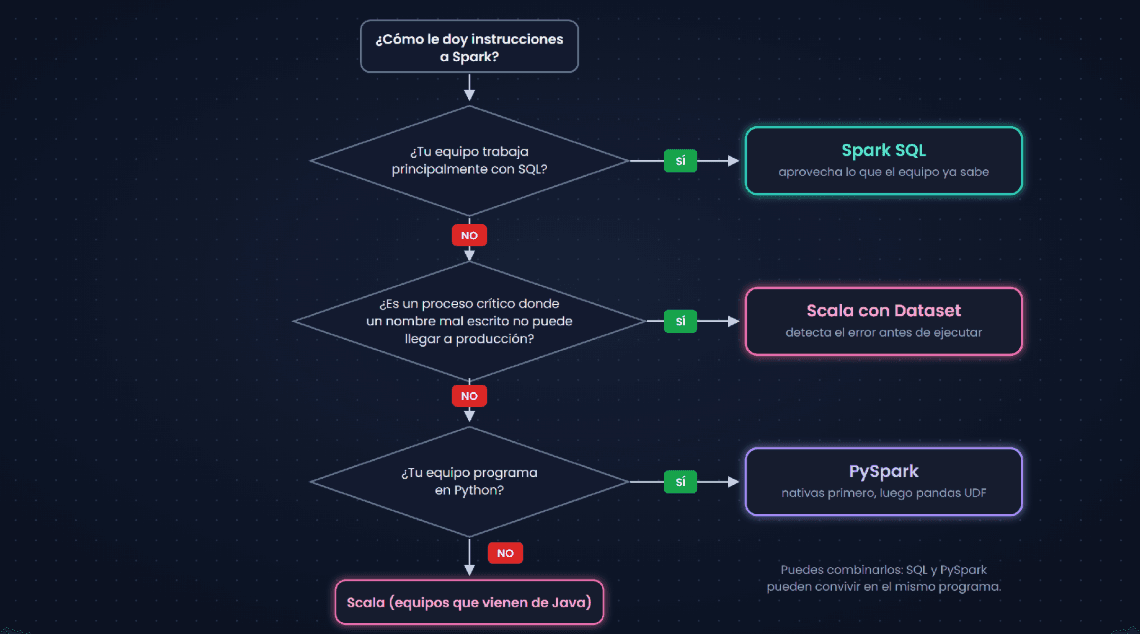
5.1. Según el tipo de trabajo
Para transformaciones y reportes, en este experimento Spark SQL y DataFrames en PySpark generaron el mismo plan, así que conviene elegir según lo que tu equipo lee y mantiene mejor.
Si necesitas una lógica que Spark no trae, busca primero una función nativa. Si no existe, compara las alternativas con tu propia lógica y tus datos, porque aquí la pandas UDF fue la UDF más rápida, pero eso puede cambiar según el cálculo.
En procesos críticos, Scala con Dataset agrega una revisión al compilar que detecta ciertos errores, como un campo mal escrito, antes de llegar a producción. Conviene usarla con columnas antes que con funciones propias, por el costo que vimos.
5.2. No tienes que elegir uno solo
En la práctica los tres conviven. Desde un programa en Python puedes preparar los datos, darle un nombre a la tabla y consultarla con SQL.
SQL y Python en el mismo programa:
Python
from pyspark.sql import functions as F
viajes_con_dia = viajes.withColumn("dia", F.to_date("tpep_pickup_datetime")) # Python
viajes_con_dia.createOrReplaceTempView("viajes_con_dia") # nombre para SQL
resumen = spark.sql("""
SELECT dia, COUNT(*) AS total_viajes
FROM viajes_con_dia
GROUP BY dia
""") # SQL
6. Aplicación en empresas y buenas prácticas
6.1. Beneficios para el negocio
Elegir bien también es una decisión de negocio. Aprovechar lo que el equipo ya sabe acelera la entrega, y evitar UDF innecesarias puede reducir el costo de cómputo en la nube.
En banca y fintech, el monitoreo de fraude puede combinar reglas que los analistas escriben en SQL con modelos que el equipo de datos mantiene en Python, sobre el mismo motor. Quien migra sus procesos ETL puede pasar las cargas nocturnas a Spark sin reentrenar a todo el equipo. Ambos casos coinciden con los usos que Kranio describe en su página de Spark (Kranio, s. f.).
Si quieres ver cómo encaja esto en un flujo ETL o ELT, revisa nuestro artículo ETL vs ELT: diferencias, casos de uso y mejores herramientas.
6.2. Buenas prácticas
- Prefiere funciones nativas antes que UDF. Si necesitas una en Python, mide alternativas como la pandas UDF con tu lógica y tus datos antes de elegir.
- Antes de optimizar, revisa el plan con explain(), la instrucción que muestra los pasos que hará Spark.
- Fija la versión de Spark y revisa sus incidencias conocidas. Con la 4.2.0, nuestras UDF con Arrow se colgaban por el error SPARK-58241, corregido en la 4.2.1 (Apache Software Foundation, 2026d).
7. Conclusión: qué usar y cuándo
Las diferencias entre PySpark, Spark SQL y Scala no aparecieron en las consultas comunes, porque en este experimento, con DataFrames o SQL, el plan y el resultado fueron los mismos. Sí aparecieron en las funciones propias de Python y en la revisión de tipos de Scala. Con eso en mente, la elección queda así:
- Si tu equipo trabaja principalmente con SQL, empieza con Spark SQL y aprovecha lo que ya sabe.
- Si programa en Python, usa PySpark, prefiere funciones nativas y, cuando necesites una UDF, mide las alternativas con tus datos.
- Si viene de Java, o si en procesos críticos quieres que el compilador detecte ciertos errores antes de ejecutar, considera Scala con Dataset.
7.1. Qué probamos y qué queda fuera
Todo se probó en una sola máquina, con Spark 4.2.1 y un solo archivo. Quedaron fuera un clúster real, el procesamiento en streaming y Spark Connect, donde los planes y los tiempos pueden cambiar, así que conviene repetir las mediciones en tu entorno.
La implementación de Apache Spark con el lenguaje adecuado no solo mejora la eficiencia técnica, sino que también permite a las empresas procesar más datos en menos tiempo, reducir costos de cómputo y escalar sus pipelines de forma segura y sostenible. En Kranio contamos con equipos especializados en Apache Spark que han implementado este tipo de soluciones en proyectos empresariales reales.
👨💻 Si tu empresa busca implementar este tipo de soluciones, puedes contactarnos en 👉 www.kranio.io
Referencias
- Apache Software Foundation. (2026a). Spark overview (versión 4.2.1). https\://spark.apache.org/docs/4.2.1/
- Apache Software Foundation. (2026b). Cluster mode overview (versión 4.2.1). https\://spark.apache.org/docs/4.2.1/cluster-overview.html
- Apache Software Foundation. (2026c). Spark SQL, DataFrames and Datasets guide (versión 4.2.1). https\://spark.apache.org/docs/4.2.1/sql-programming-guide.html
- Apache Software Foundation. (2026d). SPARK-58241: Columnar Arrow Python UDF runner writes the input schema in the legacy protocol position, hanging the worker. Apache JIRA. https\://issues.apache.org/jira/browse/SPARK-58241
- Apache Software Foundation. (2026e). EXPLAIN (versión 4.2.1). https\://spark.apache.org/docs/4.2.1/sql-ref-syntax-qry-explain.html
- Apache Software Foundation. (2026f). Upgrading PySpark (versión 4.2.1). https\://spark.apache.org/docs/4.2.1/api/python/migration\guide/pyspark\upgrade.html
- Apache Software Foundation. (2026g). Chapter 5: Unleashing UDFs & UDTFs (PySpark 4.2.1). https\://spark.apache.org/docs/4.2.1/api/python/user\_guide/udfandudtf.html
- Apache Software Foundation. (2026h). Performance tuning (versión 4.2.1). https\://spark.apache.org/docs/4.2.1/sql-performance-tuning.html
- Apache Software Foundation. (2026i). Apache Arrow in PySpark (PySpark 4.2.1). https\://spark.apache.org/docs/4.2.1/api/python/tutorial/sql/arrow\_pandas.html
- Armbrust, M., Xin, R. S., Lian, C., Huai, Y., Liu, D., Bradley, J. K., Meng, X., Kaftan, T., Franklin, M. J., Ghodsi, A., & Zaharia, M. (2015). Spark SQL: Relational data processing in Spark. En Proceedings of the 2015 ACM SIGMOD International Conference on Management of Data (pp. 1383–1394). https\://doi.org/10.1145/2723372.2742797
- Kranio. (s. f.). Apache Spark. https\://www.kranio.io/technologies/apache-spark-tech
- Microsoft. (s. f.). Especificaciones y límites de Excel. Microsoft Support. https\://support.microsoft.com/es-es/office/especificaciones-y-l%C3%ADmites-de-excel-1672b34d-7043-467e-8e27-269d656771c3
- NYC Taxi & Limousine Commission. (s. f.). TLC trip record data. https\://www.nyc.gov/site/tlc/about/tlc-trip-record-data.page
- Zaharia, M., Chowdhury, M., Franklin, M. J., Shenker, S., & Stoica, I. (2010). Spark: Cluster computing with working sets. En 2nd USENIX Workshop on Hot Topics in Cloud Computing (HotCloud 10\). USENIX Association. https\://www.usenix.org/conference/hotcloud-10/spark-cluster-computing-working-sets
Entradas anteriores
Archify: cómo revisar diagramas de arquitectura con IA
Descubre cómo revisar diagramas de arquitectura generados con IA, validar sus relaciones con Archify y detectar supuestos antes de utilizarlos.
¿Data Lake o Data Warehouse? Cuál Elegir y Diferencias
¿Data Lake o Data Warehouse? Conoce sus diferencias de arquitectura, costos, casos de uso reales y cómo el Lakehouse une lo mejor de ambos mundos.